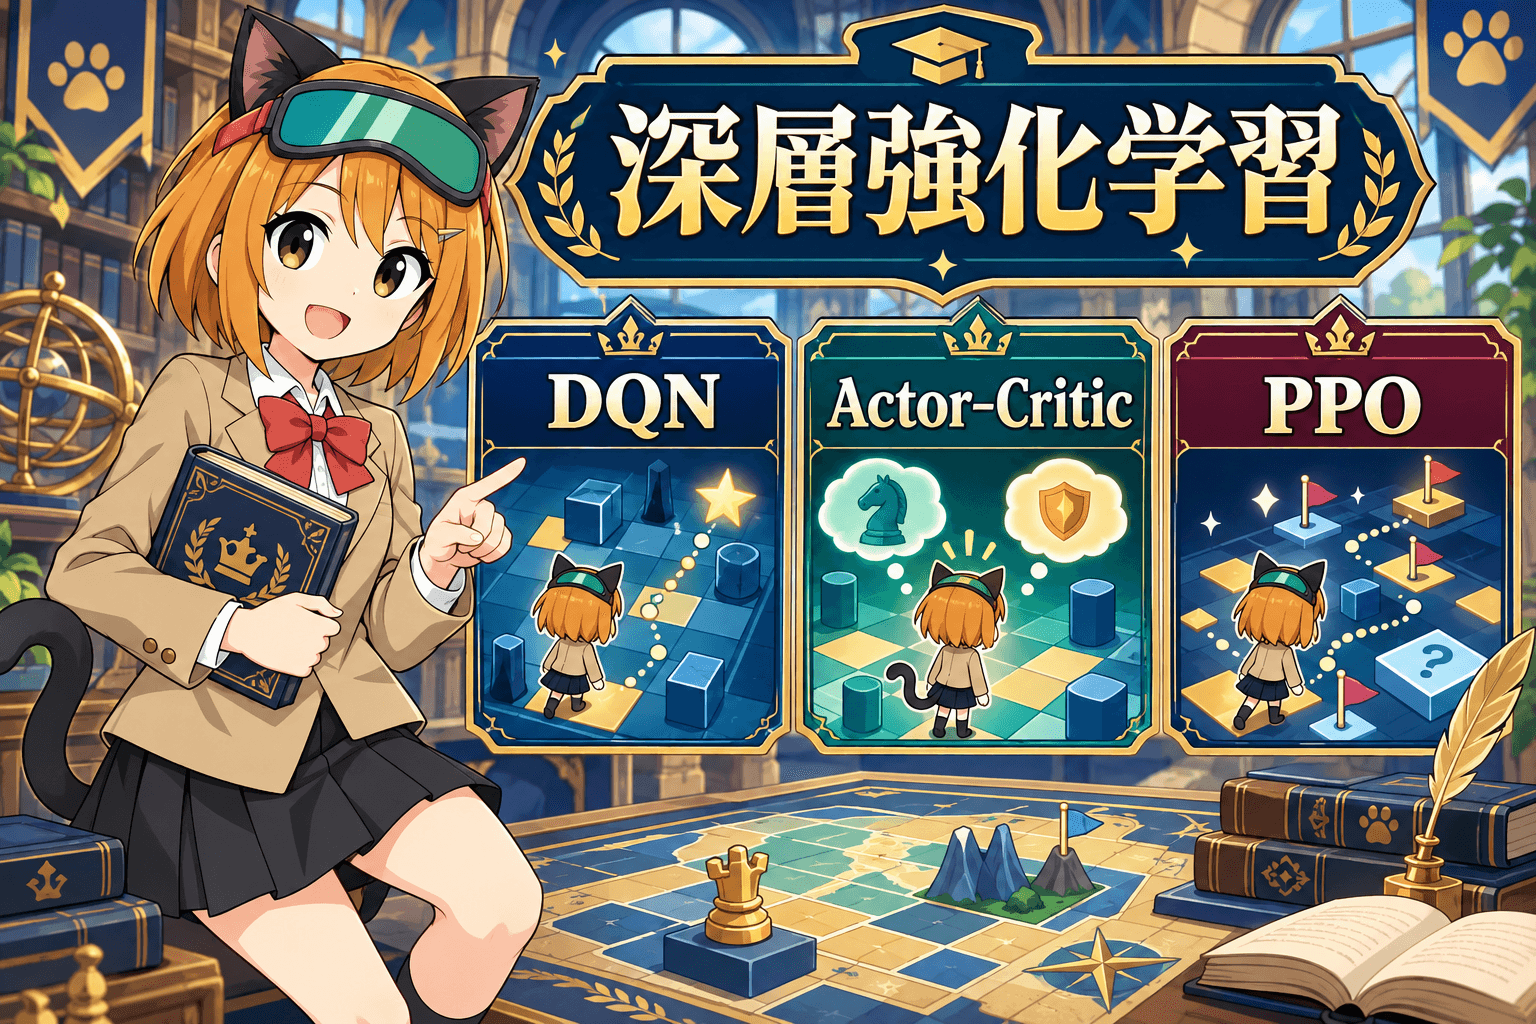
深層強化学習を実装・評価する
状態数が大きいと価値表をそのまま保存できません。深層強化学習は関数近似を使いますが、表形式の収束保証を自動的には引き継ぎません。DQN、方策勾配、PPOを目的関数から読み、評価に必要な実験設計を考えます。
記事の閲覧状態を確認しています…
広告を取得中...
状態数が大きいと価値表をそのまま保存できません。深層強化学習は関数近似を使いますが、表形式の収束保証を自動的には引き継ぎません。DQN、方策勾配、PPOを目的関数から読み、評価に必要な実験設計を考えます。
記事の閲覧状態を確認しています…